Manga OCR 指南:manga-ocr 模型安装、选型与漫画翻译
Manga OCR 是什么?这篇指南讲清 manga-ocr 和 manga-ocr-base 模型如何识别日文漫画文字,怎样用 pip 安装运行,为什么整页会读不出来,各类工具和开源翻译器分别适合什么场景,以及识别出文字之后怎样得到一张翻译好的漫画图片,并说明免费范围、使用限制和检查识别结果的方法。
 AI Manga Translator 团队
Manga OCR 指识别漫画图片里的文字。大多数人搜这个词时,想找的是一个具体项目:manga-ocr,由 kha-white 开发的免费 Python 库,它从裁好的对话气泡里读取日文并输出纯文本。它不会寻找气泡,不会翻译,也不会把文字放回页面。
所以该怎么配置 Manga OCR,取决于你最后想得到什么。想要一句可以查词的日文,就安装 manga-ocr。想要一页能直接读懂的漫画,就需要 OCR、翻译和嵌字一起完成,这正是 OCR 漫画翻译工具一步做完的事。
本文事实已于 2026 年 11 月 1 日对照 manga-ocr 公开仓库、PyPI 页面和 Hugging Face 模型文件核对。我们没有做准确率评测,因此文中不给出自测的准确率百分比。封面是为本文制作的 AI 生成插画。
Manga OCR 是什么?
OCR 是光学字符识别,把图片里的像素变成可以复制的文字。Manga OCR 把这件事用到漫画页面上:文字在气泡里,经常竖排,还会压在画面上。
名字容易混淆,因为同一个项目有好几种写法:
- manga-ocr: GitHub 仓库名,也是从 PyPI 安装的包名。
- manga_ocr: 在终端运行的命令,也是 Python 里导入的模块名,类名是
MangaOcr。 - manga-ocr-base: 库从 Hugging Face 下载的训练好的模型,完整名称是
kha-white/manga-ocr-base。 - mangaocr: 许多应用和搜索里使用的连写形式,指的是同一个引擎。
如果某个工具的设置里把 “Manga OCR” 列为引擎,通常指这个模型或它的转换版本。营销页上泛泛写的 “manga OCR” 则可能是别的东西,要看产品具体写的是哪个引擎。
漫画为什么需要专门的 OCR
文档 OCR 期待的是白底上整齐的横排文字,漫画很少这样。manga-ocr 项目针对的是几乎每页都会遇到的五类问题:
- 竖排和横排文字,经常出现在同一页。
- 振假名,印在汉字旁边的小号注音。
- 压在图像上的文字,而不是干净的留白。
- 字体和风格多样,从书籍字体到喊叫式手绘字。
- 低质量图片,比如旧扫描件和压缩过的截图。
它还能一次读取多行文字,所以整个气泡可以直接输入,不用先拆成单行。它同样可以当作通用的印刷体日文 OCR 使用,README 也提到它在小说和游戏文字上应该表现不错。只要图片是紧贴文字的小裁剪,用它从图片提取日文是个实用的选择。
manga-ocr-base 模型如何工作
manga-ocr-base 模型是端到端的视觉编码器-解码器结构:视觉 Transformer 负责看图,BERT 风格的解码器逐个 token 写出日文。训练数据是 Manga109-s 数据集加上合成数据。
| 属性 | 数值 | 为什么重要 |
|---|---|---|
| 编码器 / 解码器 | ViT / BERT | 整体读图,不需要先切行。 |
| 输入尺寸 | 224 × 224 像素 | 你输入的任何图片都会缩放成这个正方形。 |
| 颜色 | 转换为灰度 | 彩色页面也按黑白读取。 |
| 输出上限 | 300 个 token | 够读一个气泡,不是为整页文字设计的。 |
| 词表 | 6,144 个 token | 为日文设计,不是多语言模型。 |
| 模型文件 | 444 MB | 首次运行时下载,之后使用缓存。 |
| 许可(库) | Apache-2.0 | 可免费使用,也可用于其他项目。 |
输入尺寸解释了最常见的 Manga OCR 错误:直接传入整页。下面是同一页用模型自己的预处理设置缩放出来的两种结果。
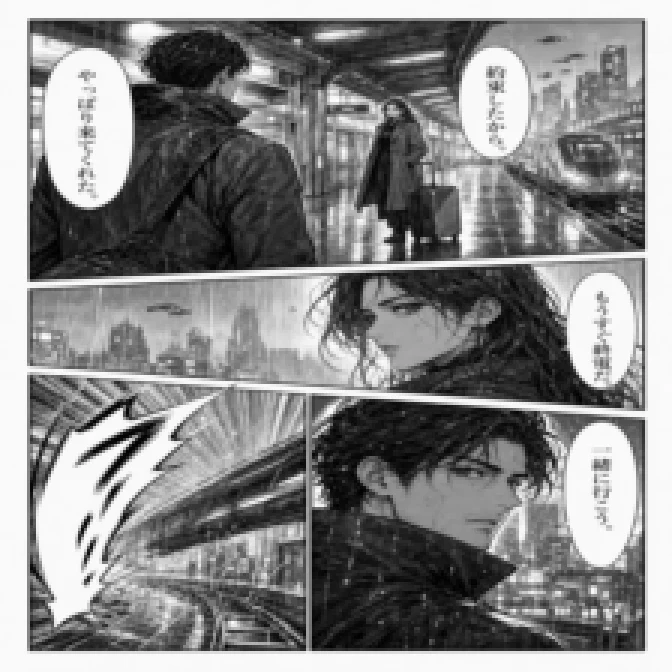
整页缩到模型输入尺寸:对白糊成一片
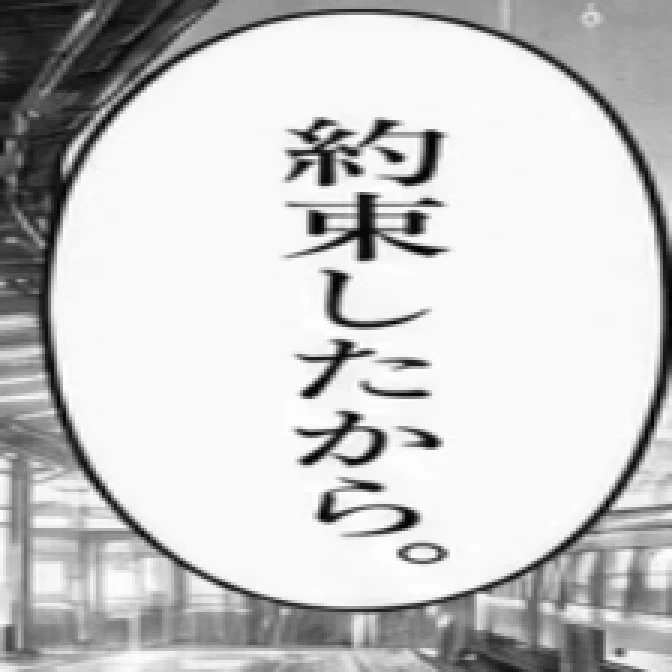
同样尺寸的气泡裁剪:每个字都保留下来
这就是这个库没有“上传整页”模式的原因。总要有东西先找到文字区域,可以是你用截图工具手动框选,也可以是 comic-text-detector 这样的检测模型。
如何安装和运行 manga-ocr
这份 Manga OCR 教程按官方 README 编写。你需要 Python 3.9 或更新版本。最新发布的 Python 可能暂时不能用,因为 PyTorch 往往需要一段时间才能适配。
1. 安装
pip install manga-ocr
使用 uv 的话,运行 uv add manga-ocr;也可以不加入项目直接试用:
uvx manga_ocr
想用 manga-ocr GPU 加速,先按 PyTorch 官方说明安装 PyTorch。库会在可用时自动选择 CUDA 或 Apple MPS,否则回退到 CPU。
2. 在 Python 里读取图片
from manga_ocr import MangaOcr

mocr = MangaOcr()
text = mocr('/path/to/bubble.png')
print(text)
可以传文件路径,也可以传 PIL 图片。首次运行会下载模型,可能需要几分钟,之后识别都在你自己的电脑上完成。
3. 或者一边看漫画一边后台运行
这是很多日语学习者的用法。先启动剪贴板监听:
manga_ocr
用 ShareX 或 Flameshot 这类工具截取一块区域,manga-ocr 会从剪贴板读取图片并写回文字,再由 Yomitan 这样的词典读取。开始前等日志出现 OCR ready。
也可以改为监听截图文件夹:
manga_ocr "/path/to/sharex/screenshot/folder"
剪贴板模式会把你复制的任何图片都替换成识别文字,如果还需要正常粘贴图片,请改用文件夹模式。
常见安装问题
DLL load failed while importing fugashi: 可能是 Microsoft Store 版 Python 造成的,可以改从 python.org 安装。- 找不到
manga_ocr命令: 试试python -m manga_ocr。 - ARM 上
mecab-python3安装失败: 参考仓库排错说明里链接的解决办法。 - Linux 剪贴板模式: Wayland 安装
wl-copy,X11 安装xclip。
哪种 Manga OCR 工具适合你?
选工具时,引擎本身没有输出用途重要。这个项目没有官方的 Manga OCR 在线服务,我们核对时 Hugging Face 上也没有该模型的推理服务商。
| 你的目标 | 从哪里开始 | 得到什么 | 代价 |
|---|---|---|---|
| 查一个气泡 | manga-ocr + 截图工具 + Yomitan | 剪贴板里的文字 | 要配 Python;手动裁剪 |
| 读完整一卷日文 | mokuro | 阅读器里每页可选中的文字 | 要配 Python;需先处理整卷 |
| 不安装就提取整页文字 | 带页面检测的浏览器 OCR,例如 PaddleOCR 漫画预设 | 可复制或下载的文字 | 气泡顺序和人名仍要检查 |
| 搭建自己的流程 | 通过 Python API 或 ONNX 导出使用 manga-ocr-base | 原始字符串 | 要自己加检测、排序和翻译 |
| 用另一种语言读这一页 | AI Manga Translator | 翻译好的页面图片 | 在线服务;需要登录;不导出文本 |
对读者来说,mokuro 是自然的下一步。它把 comic-text-detector 和 manga-ocr 结合起来,让你在浏览器里阅读可选中文字的漫画。论坛里推荐用于学习的 OCR 漫画阅读器,很多时候就是它。
Manga OCR ONNX 方面,Hugging Face 上有社区导出的版本,可用于没有 PyTorch 的运行环境。使用前先看模型卡:有些导出基于重新训练的 manga-ocr-base-2025,而我们查看时它自己的模型卡还是空模板。
MangaTranslator 用什么 OCR 模型?
如果你搜的是 MangaTranslator OCR 模型,大概率指几个开源应用中的一个。从它们公开的 README 看,大多已经不只依赖一个 Manga OCR 引擎。
| 项目 | 列出的 OCR 模型 | 值得注意 |
|---|---|---|
| MangaTranslator(meangrinch) | Manga OCR、PaddleOCR-VL-1.6 | README 写明 OCR 和翻译可走云端 API 或本地 LLM。 |
| Koharu | PaddleOCR VL 1.6、Manga OCR、Baberu OCR、Hayai OCR | 检测、OCR 和修复模型分别选择。 |
| manga-image-translator | 32px、48px、48px_ctc、mocr | 日文和韩文推荐 48px;提供 Manga OCR 文本框合并。 |
选 Manga OCR 模型的结论:紧贴文字的日文裁剪用 manga-ocr;需要多语言或整页识别时,再看 PaddleOCR-VL 或多语言引擎。这些项目更新很快,决定前请再核对当前 README。
从 Manga OCR 到漫画翻译
OCR 只是 Manga OCR 翻译流程中的一环。把一张生肉变成能读的页面要做好几件事,manga-ocr 只负责其中一件。
| 环节 | 做什么 | manga-ocr 负责吗? |
|---|---|---|
| 检测 | 找到气泡、旁白和画面上的文字 | 否 |
| 识别 | 把每个区域变成文字 | 是,仅日文 |
| 排序 | 按阅读顺序排列区域,通常从右到左 | 否 |
| 翻译 | 结合说话者和分镜语境转换文字 | 否 |
| 清理 | 从画面上去掉原文 | 否 |
| 嵌字 | 把译文放回每个气泡 | 否 |
你可以自己拼这条流程:逐块 OCR,把文字粘到翻译器,再用修图软件擦字和嵌字。这样控制力最强,打算精修发布时值得这么做。如果只是想读懂这一页,就太慢了。
OCR 漫画翻译工具会替你跑完这些环节。把完整页面上传到我们的单页漫画翻译,选好语言,它会检测文字、翻译、清理原文,并返回翻译好的图片。支持 15 MB 以内的 PNG、JPG、JPEG 或 WebP,源页面可以是日文、韩文或中文。
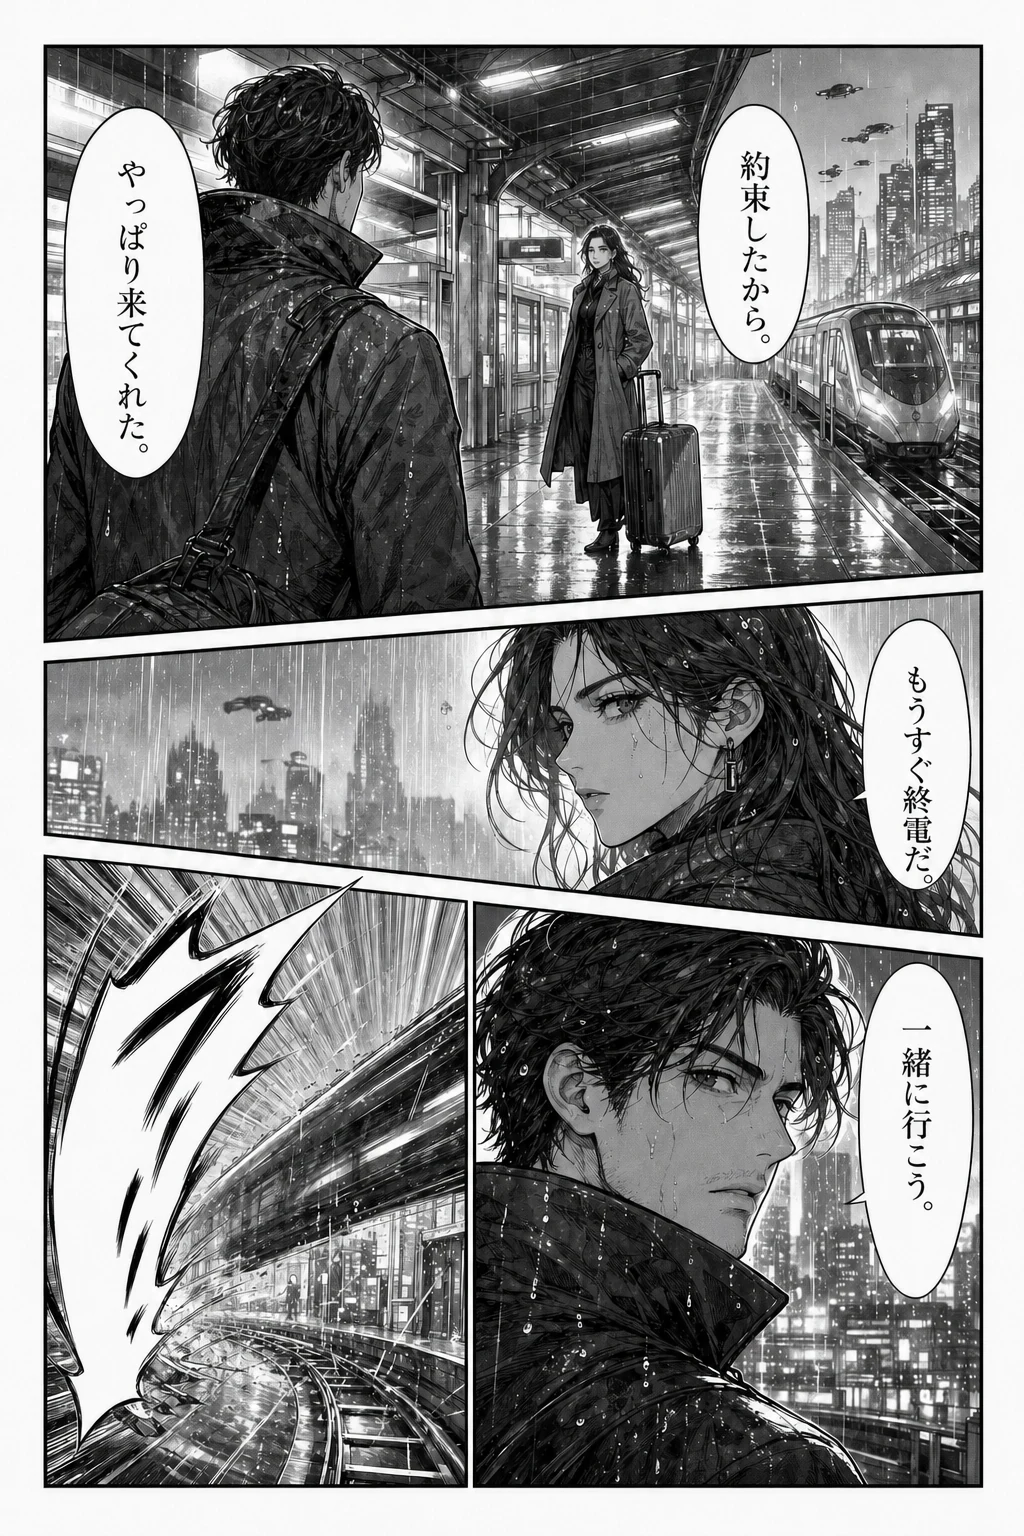
原页:日文对白
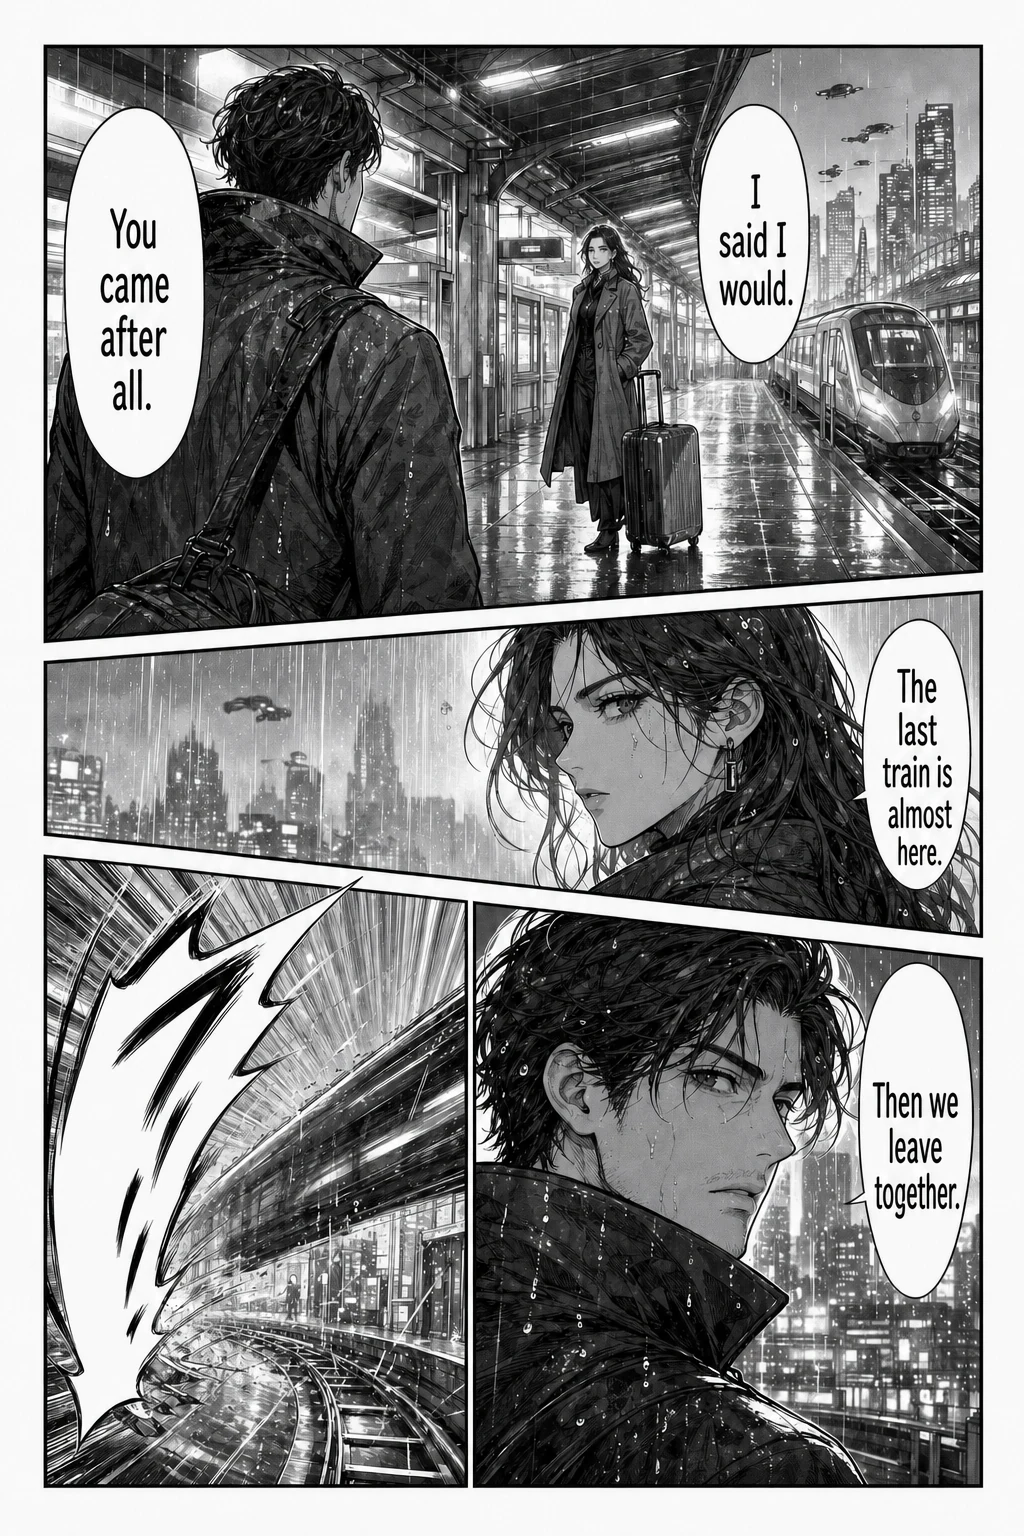
阅读版:英文对白
按来源选择流程:最多 20 张图片用批量翻译,CBZ 或 ZIP 章节用 CBZ 翻译器,正在阅读的网页图片用浏览器扩展。专门处理日文生肉时,日漫翻译指南讲了振假名、敬语和省略主语等问题。
Manga OCR 的局限与结果检查
Manga OCR 最重要的局限很容易被忽略。README 提醒,模型总会试图识别出点什么,哪怕图片里没有文字,还可能“编造”出看起来很真实的句子。读起来通顺的日文,并不能证明识别正确。
一份独立测试展示了它在哪里出错。manga-ocr 的一个 Rust 移植版公布了真实页面的结果:9 个气泡通过 4 个。失败的分别是极小的说明文字、倾斜的动作字、喊叫字、相邻文字混入,以及一个错字。这只是移植版上的一页,算不上评测,而且这一页最长的气泡反而通过了,可见单看长度无法判断成败。README 另外给出了自己的提醒:文字越长越容易出错,手写字大概率不行。
网上的准确率表格也要谨慎看待。有些 Manga OCR 文章给出 99% 以上的数字,却通常不写样本和方法。分数取决于测试页面,不如用你自己的页面试一试。
检查 Manga OCR 输出时,重点看:
- 裁剪边缘: 如果混入相邻气泡的文字,就裁得更紧。
- 长气泡: 拆开后分别再跑一次。
- 相似字符: 对照图片检查ン和ア、シ和ツ这类片假名。
- 人名: 结合上下文确认读音,模型看不到前后页。
- 空白区域: 空白或纯画面的裁剪如果有输出,一律当作编造。
- 拟声词: 自己读,它们常常是画出来的,而不是排出来的字。
翻译后的页面同样要仔细看。通顺的句子也可能来自认错的字。下载前要对比什么,可以看我们的日文漫画图片翻译指南。
Manga OCR 免费吗?
走开源路线的话,是免费的。manga-ocr 免费使用,采用 Apache-2.0 许可,模型下载后识别都在你的电脑上运行,页面留在本地。代价是安装时间、磁盘空间,以及在较慢硬件上的等待。
免费 OCR 漫画翻译工具则是另一回事,因为翻译和图片清理都有运行成本。在 AI Manga Translator 上,开始翻译需要登录,每页消耗 1 积分,任务失败会退回积分。账户里的试用积分可以用来测试页面;下载结果需要购买过积分包。当前积分包见价格页。
把页面上传到任何在线服务,都等于发送给这个服务。请先阅读隐私政策,并且只处理你拥有或获准翻译的页面。
常见问题
Manga OCR 是什么?
Manga OCR 指识别漫画图片里的文字。这个名字也常指 kha-white 开发的开源 Python 库 manga-ocr 及其 manga-ocr-base 模型。它从裁好的文字区域读取日文,输出纯文本。
manga-ocr 能读取一整页漫画吗?
不太可靠。这个库没有页面或气泡检测器,模型还会把所有输入缩放到 224 × 224 像素,整页输入后每个字几乎不剩细节。请裁出单个气泡或文字块,或者使用 mokuro 这类先检测文字区域的工具。
manga-ocr 免费吗?
免费。manga-ocr 采用 Apache-2.0 许可,在你自己的电脑上运行。你要付出的是安装时间、约 444 MB 的模型空间和硬件资源。在线翻译服务是另一回事,各有自己的限制。
manga-ocr 能识别韩漫或中文漫画吗?
不能。manga-ocr 是为日文设计的。韩漫或中文漫画请选择支持对应语言的 OCR 引擎,或者使用支持这些源语言的翻译工具。AI Manga Translator 支持日文、韩文和中文源页面。
Manga OCR 能读手写字和拟声词吗?
这两类都要当作难点。manga-ocr 的 README 说它大概率处理不了手写文字。风格化拟声词、倾斜的动作字和极小的说明文字,也是 Manga OCR 最容易出错的地方。
有安卓、iPhone 或 Chrome 上的 Manga OCR 吗?
kha-white 的库是桌面端 Python 包,不是手机应用,也不是浏览器扩展。安卓上有社区应用提供本地 OCR;我们的 Chromium 扩展可以就地翻译漫画图片,但不导出 OCR 文本。
做漫画识别时,manga-ocr 比 Tesseract 或 Google 翻译好吗?
它面向的输入不同。manga-ocr 是针对漫画字体训练的,包括竖排和振假名。网上看到的准确率数字,要先确认有没有写明方法和样本,因为结果很依赖测试用的页面。
AI Manga Translator 用的是 manga-ocr 吗?能导出 OCR 文本吗?
我们不声称使用某个特定 OCR 模型,你也不能自行选择,并且没有文本导出功能。工具返回的是翻译好的页面图片。如果你需要日文原文用于学习或自建流程,请使用 manga-ocr 或 mokuro。
选择你的下一步
想要日文文本,就安装 manga-ocr 并裁紧文字。想读懂这一页,就跳过安装:选一张对话多的页面开始,并和原图对比结果。
准备好了就开始:翻译一页漫画 →
来源:GitHub 上的 manga-ocr、PyPI、Hugging Face 模型、mokuro、manga-ocr-rs 测试结果。开源项目的细节会随版本变化。